公開日:2024年7月9日
ドン・サイモンズ
Dynata 北米営業担当エグゼクティブ・バイス・プレジデント
「シンセティック・サンプリング」とは何ですか?
合成サンプリングとは、市場調査において、コンピュータアルゴリズム、特に大規模言語モデル(LLM)を活用して、回答やシナリオをシミュレーションし、データを生成する手法です。この手法では、現実世界の回答や行動を模倣した人工データを作成することで、従来の調査手法や人間によるパネル調査のみに依存することなく、消費者の嗜好、意見、トレンドに関する洞察を得ることができます。 既存の人間によるデータセットを分析した後、AIを活用した合成データ生成ツールは、「実際の」データと同様の統計的特性を維持したデータを生成することができます。合成データは完全に人工的なものであり、生成アルゴリズムによって作成されます。
なぜ今、これほど話題になっているのか?
市場調査の分野では、長年にわたり「欠損データの補完」やデータの「推計」、そして「もし~なら」という仮説を検証するシナリオツールの活用が行われてきました。今日の「合成サンプル」は、こうした機能の延長線上にあるものであり、より強力で拡張性が高いものの、最近の議論でしばしば言われているような、まったく新しい開発というわけではありません。この機能の有用性や応用範囲を評価するにあたり、これが新しいソリューションではないということを改めて認識しておくことが重要です。
確かに、現在でも適切な活用事例は存在し、今後さらに増えていくものと予想されます。しかし、単なる興奮だけで非合理的な結論に飛びつくことには注意が必要です。多くの新しい技術と同様に、これを市場調査のツールキットに責任を持って組み込んでいくことが重要となるでしょう。「合成データさえあれば十分だ」といった現在の誇張された主張は無視すべきです。
このブームを煽っているのは、6月13日付の『MarketingWeek』に掲載されたマーク・リトソンの記事のようなもの。同記事で彼は、合成データは実データと同等の価値があると主張している。場合によってはそうである可能性もあることは疑いないが、すべてを、そして合成データのみで賄うことは不可能だ。モデルを学習させるためにはシードデータが必要であり、そのデータは消費者の声から真正に得られたものでなければならない。
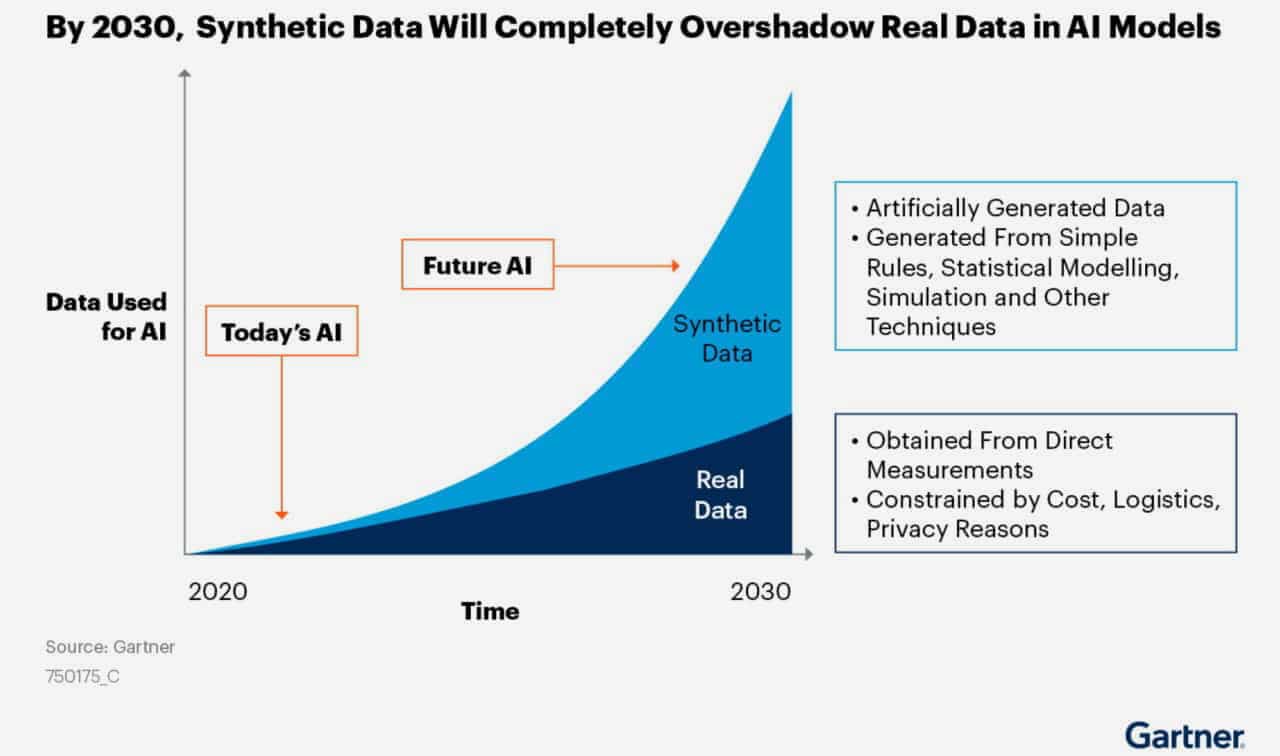
さまざまな懸念があるにもかかわらず、ガートナーは、2030年(あと6年!)までに、AIで使用されるデータの大部分が合成データになると予測しています。
本当に本番に耐えられるのか?
私の同僚である@Steven Millmanが述べているように:「合成パネルは、基礎となる仮定を母集団に適用してシミュレーションを行う際に有益です。例えば、消費者データを保有する企業は、LLMを活用してデータの欠落部分を補完し、仮定に基づいた「もし~なら」というシナリオを検討することができますが、その根底にあるバイアスを認識することが極めて重要です。 欠損データが少量の場合、AIやLLMモデルは空白を埋めるのに役立ちます。しかし、基礎となるデータに欠陥があると、単純化されすぎたり、退行的であったり、偏見に満ちた応答が生成されるリスクがあるため、正確な結果を得るにはデータの質が重要です。さらに、AIモデルはコーディングの「コパイロット」として有用であることが実証されており、開発者が効率的にコードを記述・改良するのを支援しています。」
さらに検証が必要な点としては、以下のような懸念があります:
- これらのモデルは、欠陥や偏りがある可能性のあるデータソースに依存しており、こうした偏りについては、少なくとも理解しておく必要がある。 キャシー・オニールの 『数学の破壊兵器』 は、2016年にこの懸念を浮き彫りにした。
- それらは 過去の行動パターンに基づいて学習されています。消費者の行動を変えるような重大な出来事が発生した場合――例えば、コロナ禍の前後を例に挙げると、事後的な分析の有用性は大幅に低下します。
- モデルは学習データセットの範囲内に制限されます。例えば、ChatGPTの学習データセットは2年前のもののため、新製品や時事問題、さらには現在大統領選に立候補している人物についてさえも知りません。
- このため、トレーニングセットのデータが最高品質であり、真に「信頼できる情報源」であることを確保することがこれまで以上に重要となっており、合成データを利用するすべてのユーザーに対して、そのソースデータを透明性をもって開示することが極めて重要となる。
- AIモデルには「幻覚」を起こし、事実をでっち上げる傾向があることが明らかになっていますが、その理由はまだよくわかっていません。
合成サンプルの早期導入とその可能性には、確かに期待を寄せています。特に、見つけるのが極めて困難(したがって測定も難しい)な対象層について、より信頼性の高いデータを提供できるようになる点に期待しています。しかし、私たちは責任を持って取り組まなければなりません。なお、これは「これに反対する」という意味ではなく、客観的な評価を確実に行うことを意味します。
さて、どうする?
ほとんどのアプリケーションにはさらなるテストが必要であり、我々は、テストやトレーニングが、実績のある高品質なデータを用いて行われていることを実証しなければなりません。LinkedIn上の LinkedIn上のNik Samoylov氏による最近のコメントは、私たちが乗り越えなければならないハードルを的確に要約している。「市場調査で合成データの導入を推進している人々は、自問すべきです。「選挙で有権者を合成票に置き換えたいのか?」と。もしそれができないのであれば(そして、彼らもできないことに同意してくれることを願いますが)、有意義で独自の一次調査の代わりに合成データを使用することはできないのです。」
Dynataでは、機械学習やLLMを多岐にわたる用途で活用しており、特にデータの品質を確保するとともに、革新的な技術が登場するたびに、自社のベストプラクティスを継続的に進化させています。業界全体の議論に参加し、私たちが得た知見をもとに顧客へのアドバイスを行うことは、常に私たちの喜びです。