課題は、不適切な回答者を排除することだけではありません。適切な回答者を排除しないようにすることこそが課題なのです。
データ品質は、調査業界において常に課題となっており、不注意を減らし、不正を防止する方法が議論の中心となっています。リスクが高まり、単純なチェックでは不正行為者を特定することが難しくなるにつれ、利用可能なツールは高度化・多様化しており、そのすべてが不正問題の「解決策」であると謳っています。
単純なデータクレンジング手法は、過剰なクレンジングを招く恐れがある
理論上、理想的な結果は、不正行為者がアンケートに参加する前に特定し、データ品質への悪影響を防ぐことです。デジタルフィンガープリントやその他の一律的なアプローチといった単純なデータクレンジング手法は、回答者の質を包括的に把握するのではなく、限られた指標に依存しています。より広い文脈がなければ、これらの手法では、真の不正行為と正当な回答者の行動とを区別することが困難になる場合があります。その結果、過剰なクレンジングが行われ、その過程で質の高い回答者が除外されてしまうことがよくあります。
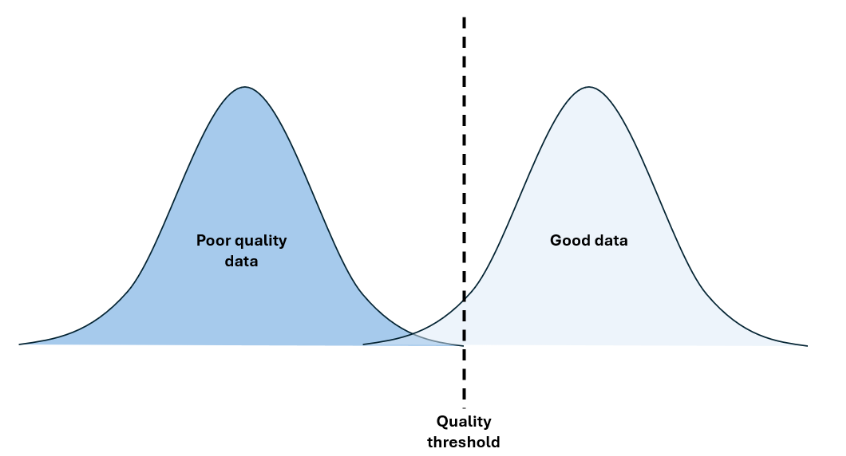
理想的な状況であれば、良質なデータと質の低いデータ間の信号の重複は最小限に抑えられ、実際の回答者に与える影響を最小限に抑えつつ、すべての不正を捕捉できるよう「閾値」を設定できるはずです。
「有罪が証明されるまでは無罪」――この原則を、データ品質の測定にも適用すべきである
刑事司法制度が有罪の認定にどのように取り組んでいるかを考えてみましょう。危険な人物が野放しになることを望む人は誰もいませんが、無実の人を誤って有罪とすることも同様に深刻な失敗であり、むしろそれ以上に悪いことだとさえ言えるでしょう。まさにそれこそが、立証責任が重要である理由です。単一の状況証拠だけでは不十分です。判決を下す前に、証拠は裏付けられ、文脈を踏まえて検討されなければなりません。
不正検出も同様に機能すべきです。単一のシグナル(例えば、共有IPアドレス、見慣れないデバイス、平均よりわずかに速い回答完了時間など)は、状況証拠に他なりません。その回答者の履歴、調査全体を通じた行動、および調査中の実際のパフォーマンスに関する文脈がなければ、その回答者をデータセットから除外することは慎重な選択とは言えません。 それは「冤罪」に他なりません。そして、そのコストは目に見えないからといって消えるわけではありません。データの歪み、スクリーニングアウト率の過大評価、そして回答者確保が困難になる調査といった形で現れるのです。回答者を除外するための立証責任は高く設定されるべきであり、その判断は、ある特定の時点での単一のシグナルではなく、複数のシグナルに基づいて行われる必要があります。
データ品質に関するシグナルが限られていると、死角が生じる
質の高い回答者と質の低い回答者にまつわるシグナルはしばしば重なり合うため、両者を明確に区別することは困難です。基本的なデジタルフィンガープリントの取得や、その情報を外部データベースと照合するといった限られたシグナルに基づいて判断を行う場合、誤分類のリスクが大幅に高まります。以下の閾値Bが示すように、不正を排除するために、正当な回答者の半数以上が除外されてしまう可能性があります。多くの場合、それは、本来であれば価値のある正確なデータを提供してくれるはずの、関与度の高い回答者を排除することにつながります。 これに対し、閾値Aでは、質の低い回答者の大部分が排除される一方で、適切な行動をとる回答者への影響はより妥当な範囲に抑えられています。
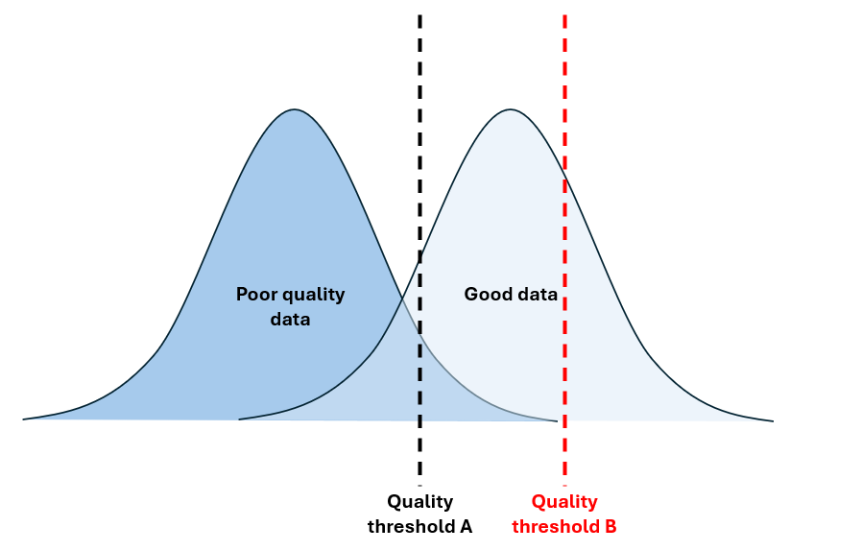
実際には、これら2つのグループの重複率は不明であり、両者を区別するために使用される指標によっても変化する可能性があります。こうした判断は限られた指標に基づいて行われるため、回答者の質を示すより広範な行動パターンを見逃してしまう恐れがあります。その結果、質の高い回答者が、その価値を発揮する機会すら得られないうちに選別されてしまう可能性があります。
品質には微妙なニュアンスがあり、ある特定の時点において収集されたわずかなデータポイントだけでは正確に評価することはできません。ある特定の時点におけるシグナルだけでは得られる文脈は限定的であり、回答者の過去の行動、エンゲージメントの傾向、あるいは調査中のパフォーマンスを反映していない可能性があります。これらのより広範な指標を総合的に検討することで、回答者の品質についてはるかに信頼性の高い見通しが得られ、回答者の除外判断において重要な役割を果たすべきです。
最も重要な点は、質の高い意思決定を行うために限定的なシグナルに依存すると、「過剰なスクリーニング」という重大なリスクが生じるということです。過剰なスクリーニングが行われると、研究者は不正な回答者だけでなく、正当で注意深く、高い関与度を持つ参加者までも意図せず排除してしまう可能性があります。これにより、結果が歪められ、データセットにバイアスが生じ、スクリーニングアウト率が人為的に高まり、発生率が低下し、調査の遂行が困難になる恐れがあります。 言い換えれば、組織は気づかないうちに回答者からの貴重な貢献を犠牲にしてしまい、結果としてサンプルの質を向上させるどころか、かえって低下させてしまう可能性があるのです。
最終的な予期せぬ結果として、多くの回答者にとって不快な体験となり、その結果、回答者エコシステムに長期的な影響が及ぶ可能性があります。
実際にはどのような形になるのでしょうか?
ある大都市圏の住民を対象とした調査を例に考えてみましょう。データクレンジングツールは、同じIPアドレス範囲から送信された回答のクラスターを検出して削除しました。これは、投票の不正操作や組織的なボット活動の兆候としてよく見られるものです。一見したところ、その論理は妥当に見えます。
そのクリーニングツールが知らなかったのは、そのIPアドレス範囲が、大規模な高齢者向け居住施設に属していたということでした。回答者は実在の人々であり、一貫したパネル履歴を持ち、調査に真摯に取り組む高齢者のグループで、全員が施設が管理する単一のWi-Fiネットワークを共有していました。彼らは同じルーターを介して接続していたため、その回答は、ツールが検出するように設計されていたパターンを引き起こしてしまったのです。 まさにその層を対象として設計された調査から、関与度の高い層による30件近くの回答が、知らぬ間に削除されてしまった。クォータの達成が難しくなり、発生率は人為的に低く見え、残されたインサイトは、クライアントが最も理解を望んでいた人々を十分に反映していないものとなってしまった。
このようなエラーは珍しくありません。IPアドレスの共有は至る所で見られます。マンション、大学、企業のオフィス、病院、図書館、そして衛星インターネットを利用する地方のコミュニティなどです。1つのIPアドレスが、数十人のまったく別々の、完全に正当な個人を表していることもあります。IPアドレスの共有を不正の証拠として扱うことは、データの精度を高めるどころか、現実の世界を反映したデータではなくなってしまいます。
この課題は、IPアドレスというレベルにとどまりません。人間の行動は実に複雑です。子供の迎えの合間にアンケートに回答する親、午前3時に回答する夜勤の労働者、あるいは常にVPNを利用するプライバシーを重視する参加者など、これらはいずれも、単独で見れば不審な行動パターンとして映りかねません。
数多くの調査ややり取りを通じて得られる、その人物の全体像に照らし合わせれば、その人はごく普通の人です。一律のクリーニングルールは、そうした複雑さを平準化してしまいます。それらは、外れ値と不正行為者を区別せず、その結果、調査に意味を与えるような、現実的で多様な回答者たちをまさに排除してしまうのです。
目標は、不適切な回答者を排除すること、あるいはさらに言えば、そうした回答者がそもそも参加できないようにすることです。
当社は、被験者の募集から回答、データ納品に至るまでのプロセスのあらゆる段階で、調査の品質を保護することを重視しています。 ただし、特に回答者の履歴や行動パターンを考慮していない品質評価ツールを使用する際は、これらの点を念頭に置いておくことが重要です。こうしたツールの使用により、特に複数のプロバイダーやパネルを横断してスクリーニングアウト率が著しく高くなる場合は、そのトレードオフが適切かどうかを検討し、回答者の品質と正確なインサイトのバランスをより良く取るために、ツールが使用する閾値を調整することを検討する価値があります。
ある特定の瞬間に取得されたデジタルフィンガープリントよりも、回答者に関するはるかに多くの情報を保有するファーストパーティデータプロバイダーと連携することが重要です。回答者の質を評価するには、過去のパフォーマンス、エンゲージメントの傾向、調査中の行動など、複数の調査にわたる行動を包括的に把握することが最も効果的です。
文脈は重要です。全体像がより明確であればあるほど、組織は、正確なインサイトを得るために不可欠な、意欲的で質の高い回答者を維持しつつ、真に質の低い回答者を的確に特定できるようになります。これが、QualityScoreのような高度な調査内品質測定指標が非常に価値がある理由でもあります。こうした指標は、外部のシグナルだけに頼るのではなく、実際の調査行動を評価することで、回答者の質をより正確に評価し、データクレンジングによって単にサンプル数を減らすのではなく、成果の向上につながるよう支援します。